Структуры
- Углубленное видео по базовому синтаксису, часть со структурами
- Видео по техникам программирования, где описывается как работают структуры
Концепты
Заголовок раздела «Концепты»- Пользовательские типы данных
- Структура для объединения связанных переменных
- Структура как абстракция (компьютерный зал состоит из столов и компьютеров)
- Поле
- Инициализация структур
- Указатель на структуру
- Отступ поля
- Оператор
->
Примеры на понимание
Заголовок раздела «Примеры на понимание»Проанализируйте, что происходит в примерах:
1. Инициализация структуры
Заголовок раздела «1. Инициализация структуры»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a { 1, 2 }; std::cout << a.f1 << std::endl; std::cout << a.f2 << std::endl;}Ответ:
По умолчанию, можно использовать синтаксис инициализации через фигурные скобки для любых структур. Это задаст значения полям по очереди, в порядке их объявления.
Выведется 1 и 2.
2. Выражение типа структуры
Заголовок раздела «2. Выражение типа структуры»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a = A{ 1, 2 }; std::cout << a.f1 << std::endl; std::cout << a.f2 << std::endl;}Ответ:
Произойдет то же, что и выше.
Какой тип у выражения A{ 1, 2 }
Тип переменных не обязательно целочисленный (int, uint8_t),
а может быть и пользовательским.
В данном примере A — это пользовательский тип данных.
A{ 1, 2 } это выражение типа A.
Более расширенно можно сказать,
что статический (известный при компиляции) тип значения,
которое будет получено в ходе вычисления выражения A{ 1, 2 } — это A.
Как может быть тип, который не int?
Такое выражение можете воспринимать как кусочек памяти с двумя полями f1 и f2,
значения которых 1 и 2, как на картинке ниже.
Воспринимайте это как просто взвешенные в воздухе временные данные, они не сохранены
где-либо в оперативной памяти.
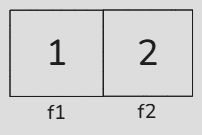
Тот факт, что тип выражения является A означает,
что результат вычисления выражения можно будет сохранить в переменную типа A.
Теперь, это “взвешенное” значение уже попадет в переменную a.
А оно может попасть туда, потому что у переменной a тип A,
что совместимо с типом выражения A{ 1, 2 } (тоже тип A).
3. Присвоение структуры к int
Заголовок раздела «3. Присвоение структуры к int»#include <iostream>
struct A{ int f1; int f2;};
int main(){ int a = A{ 1, 2 }; std::cout << a << std::endl;}Ответ:
Не скомпилируется, поскольку у выражения A{ 1, 2 } тип A, а у a тип int.
Значение типа A нельзя сохранить в переменную типа int.
4. Операции с полями
Заголовок раздела «4. Операции с полями»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a; a.f1 = 5; int b = a.f1; a.f2 = b;
std::cout << a.f1 << std::endl; std::cout << a.f2 << std::endl; std::cout << b << std::endl;}Ответ:
Можно считывать из и вписывать в каждое из полей по отдельности.
Выведется 5 трижды.
5. Присваивание структуры
Заголовок раздела «5. Присваивание структуры»struct A{ int f;};int main(){ A a{ 1 }; A b{ a }; a.f = 2; std::cout << a.f << std::endl; std::cout << b.f << std::endl;}Ответ:
Синтаксис создает независимые копии полей.
A a{ 1 } создает переменную a с полем f = 1.
A b{ a } создает новую переменную b и копирует в нее значения всех полей из a.
На этот момент b.f станет 1, но это отдельная копия в отдельной памяти.
Поэтому a.f = 2 меняет только a, а b остается нетронутым.
Выведется 2 и 1.
6. Адреса полей
Заголовок раздела «6. Адреса полей»#include <iostream>
struct A{ int f;};
int main(){ A a; int* b = &a.f; *b = 5; std::cout << a.f << std::endl;}Ответ:
Можно получать адрес на поле изнутри переменных, типа структуры.
На строчке int* b = &a.f, в &a.f, точка выполняется первой,
давай доступ к полю f внутри a,
затем получаете ее адрес, используя &.
В a.f будет сохранено значение 5.
7. Присваивание переменной структуры (1)
Заголовок раздела «7. Присваивание переменной структуры (1)»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a; a.f1 = 5; a.f2 = 6;
A b; b = a;
std::cout << a.f1 << std::endl; std::cout << a.f2 << std::endl;
std::cout << b.f1 << std::endl; std::cout << b.f2 << std::endl;}Ответ:
b = a копирует значения всех полей a в b.
8. Присваивание переменной структуры (2)
Заголовок раздела «8. Присваивание переменной структуры (2)»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a; a.f1 = 5; a.f2 = 6;
A b; b.f1 = 7; b = a;
std::cout << a.f1 << std::endl; std::cout << a.f2 << std::endl;
std::cout << b.f1 << std::endl; std::cout << b.f2 << std::endl;}Ответ:
b = a не знает от том, какие поля уже инициализированы.
Он копирует все поля, без разбору.
По итогу, в b будет f1 = 5, f2 = 6.
9. Адрес структуры (1)
Заголовок раздела «9. Адрес структуры (1)»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a; a.f1 = 5; a.f2 = 6; A* pa = &a; A b = *pa;
std::cout << b.f1 << std::endl; std::cout << b.f2 << std::endl;}Ответ:
На строчке b = *pa, *pa по сути эквивалентно прямому обращению к переменной a. Ситуация та же, что выше.
10. Адрес структуры (1)
Заголовок раздела «10. Адрес структуры (1)»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a; a.f1 = 5; a.f2 = 6; A* pa = &a; a.f1 = 7; A b = *pa;
std::cout << b.f1 << std::endl; std::cout << b.f2 << std::endl;}Ответ:
В b.f1 попадет 7.
Оператор & берет не адрес значения f1 = 5, f2 = 6,
а адрес переменной a.
Считывая по адресу, всегда получите текущее значение a.
11. Оператор ->
Заголовок раздела «11. Оператор ->»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a; a.f1 = 5; A* pa = &a; (*pa).f2 = 6; pa->f1 = 7;
std::cout << a.f1 << std::endl; std::cout << a.f2 << std::endl;}Ответ:
*pa по сути эквивалентно обращению к a напрямую.
(*pa).f2 = 6 -> a.f2 = 6.
pa->f1 означает “перейди на переменную по адресу из pa, потом обратись к полю f1”.
Это по-другому можно выразить как (*pa).f1.
И это будет по факту эквивалентно a.f1.
12. Перезапись по адресу
Заголовок раздела «12. Перезапись по адресу»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a{}; A* pa { &a }; *pa = { 5, 6 }; std::cout << pa->f1 << std::endl; std::cout << pa->f2 << std::endl;}Ответ
*fp = { 5, 6 } -> *(&a) = { 5, 6 } -> a = { 5, 6 }
Это значит a.f1 = 5, a.f2 = 6.
fp->f1 считывает, что в данный момент ннаходится в a. Так как до этого туда вписали 5, выведется 5.
Аналогично для fp->f2 — 6.
13. Адрес типа структуры
Заголовок раздела «13. Адрес типа структуры»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A* fp { &A }; *fp = { 5, 6 }; std::cout << fp->f1 << std::endl;}Ответ:
Подобное недопустимо, поскольку сама структура A не хранит никаких данных.
Данные можно хранить в переменной типа A, которую необходимо заранее создать.
14. Адрес поля типа
Заголовок раздела «14. Адрес поля типа»#include <iostream>
struct A{ int f1; int f2;};
int main(){ int* fp { &A.f1 }; *fp = 5; std::cout << *fp << std::endl;}Ответ:
Подобное недопустимо. Объяснение то же, что и в прошлом примере.
15. Адресное поле
Заголовок раздела «15. Адресное поле»#include <iostream>
struct A{ int* f1;};
int main(){ int num = 1; A a; a.f1 = # *a.f1 = 2;
std::cout << a.f1 << std::endl; std::cout << num << std::endl;}Ответ:
В *a.f1, * применится после ., то есть:
*a.f1 -> *(&num) -> num.
После этого, num перезаписывается на 2.
Выведется адрес num, а затем 2.
16. Поле массива из адресов
Заголовок раздела «16. Поле массива из адресов»#include <iostream>
struct A{ int* f[2];};
int main(){ int var1; int var2; A a { .f = { &var1, &var2 } }; *a.f[0] = 1; *a.f[1] = 2; int** b = a.f; int c = **b;
std::cout << var1 << std::endl; std::cout << var2 << std::endl;
std::cout << a.f[0] << std::endl; std::cout << a.f[1] << std::endl;
std::cout << b << std::endl; std::cout << c << std::endl;}Ответ:
Строчка A a { .f = { &var1, &var2 } }; инициализирует a,
вписав в поле a.f[0] адрес на var1 и в a.f[1] адрес на var2.
В строчке *a.f[0] = ..., происходит переход по адресу, сохраненному в a.f[0]:
*a.f[0] -> *(a.f[0]) -> *(&var1) -> var1.
В int** b = a.f;, a.f эквивалентно &(a.f[0]).
Это дает ссылку на первую ячейку в массиве f в a.
Выведется:
1,2как значенияvar1иvar2;- адреса
var1иvar2как значенияa.f[0]иa.f[1]; cбудет равно1.
17. Вложенная структура
Заголовок раздела «17. Вложенная структура»#include <iostream>
struct Nested{ int f;};
struct A{ Nested nested; int f;};
int main(){ A a { .nested = { .f = 1 }, .f = 2, };
a.f = 3; a.nested = { 5 }; a.nested.f = 6;
std::cout << a.f << std::endl; std::cout << a.nested.f << std::endl;}Ответ:
В структуры можно вкладывать любые другие структуры. Это называется nesting. Эта техника применяется постоянно при программировании.
Здесь, по итогу a.f будет равно 3, а a.nested.f будет равно 6.
18. Копирование вложенной структуры
Заголовок раздела «18. Копирование вложенной структуры»#include <iostream>
struct Nested{ int f;};
struct A{ Nested nested; int f;};
int main(){ A a { .nested = { 1 }, .f = 2 }; A b { a };
a.nested.f = 3; a.f = 4;
std::cout << b.nested.f << std::endl; std::cout << b.f << std::endl; std::cout << a.nested.f << std::endl; std::cout << a.f << std::endl;}Ответ:
A b{ a } копирует значения всех полей, включая вложенную структуру целиком.
На момент копирования в a лежит nested.f = 1, f = 2,
поэтому в b попадут те же значения: b.nested.f = 1, b.f = 2.
Но это отдельная копия в отдельной памяти: сама структура Nested
хранится внутри A по значению, а не по адресу.
Поэтому последующие изменения a.nested.f = 3 и a.f = 4
меняют только a, а b остается нетронутым.
Выведется 1, 2, 3, 4.
19. Почему данный код не скомпилируется?
Заголовок раздела «19. Почему данный код не скомпилируется?»struct A{ int value; A other;};Ответ:
Нельзя вкладывать структуру в саму себя, потому что тогда она будет занимать бесконечно памяти. Возможно вложить указатель на другую такую структуру, поскольку его размер не зависит от размера структуры.
20. Связный список
Заголовок раздела «20. Связный список»#include <iostream>
struct Node{ int value; Node* next;};
int main(){ Node end{}; end.value = 1; end.next = nullptr;
Node start{}; start.value = 2; start.next = &end;
Node* current = &start; std::cout << current->value << std::endl;
current = current->next; std::cout << current->value << std::endl;
current = current->next; std::cout << current->value << std::endl;}Ответ:
Здесь создается так называемый linked list (связный список), что очень часто применяется в программировании.
Суть в том, что структура имеет ссылку на другую такую же.
Конец списка указывается отсутствием указателя в последнем звене списка (nullptr).
Код выведет 2, 1, а затем крашнется на последней строчке при попытке считать по нулевому адресу с отступом (segmentation fault).
21. Размер структуры (1)
Заголовок раздела «21. Размер структуры (1)»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A a; std::cout << sizeof(a) << std::endl; std::cout << sizeof(A) << std::endl;}Ответ:
sizeof(a) дает размер переменной в байтах.
sizeof(A) дает размер переменной типа A в байтах, если такую создать.
Обе записи эквивалентны.
Результат будет 8, потому что в каждой структуре по 2 int, каждый из которых занимает 4 байта.
22. Размер структуры (2)
Заголовок раздела «22. Размер структуры (2)»#include <iostream>
struct A{ int f1[4]; int* f2;};
int main(){ std::cout << sizeof(A) << std::endl;}Ответ:
int f1[4]- это 4int, каждый по 4 байта - 16 байт;int* f2- 8 байтов на 64-битном процессоре.
В сумме 24 байта.
23. Адрес поля из адреса структуры
Заголовок раздела «23. Адрес поля из адреса структуры»#include <iostream>
struct A{ int f;};
int main(){ A a { 1 }; A* pa { &a }; int* pf { &pa->f }; *pf = 2; std::cout << a.f << std::endl;}Ответ:
Здесь демонстрируется тот факт, что можно брать адрес поля после применения ->.
& применяется после ->, а также аналогично с ..
&pa->f -> &(pa->f) -> &((*pa).f) -> &(a.f)
Выведется 2.
24. Адрес поля относительно адреса структуры
Заголовок раздела «24. Адрес поля относительно адреса структуры»#include <iostream>
struct A{ int f;};
int main(){ A a { }; A* pa { &a }; int* pf { &pa->f }; ptrdiff_t diff { reinterpret_cast<uint8_t*>(pf) - reinterpret_cast<uint8_t*>(pa) }; std::cout << diff << std::endl;}Ответ:
Выведется 0.
Первое поле структуры и сама структура всегда находятся по тому же адресу в памяти.
25. (продвинутый уровень): Размер структуры (3)
Заголовок раздела «25. (продвинутый уровень): Размер структуры (3)»#include <iostream>
struct A{ uint8_t f1; int f2; uint8_t f3;};
int main(){ std::cout << sizeof(A) << std::endl;}Ответ:
Тут в силу входит alignment. alignment делает так, что между полями остаются пустые места. Это делается потому, что процессору так быстрее считывать данные из памяти.
Сначала определяется поле с наибольшем размером, обычно до 16 байтов.
В данном примере, это int - 4 байта.
Теперь, делим память на окошки по 4 байта. Если последующее поле не влезает целиком в оставшееся окошко по 4 байта, оно попадает в следующее.
uint8_t f1попадет в первый байт первого окошка;int f2не влезает в первое окошко послеf1, поэтому попадет в следующее. Оставшиеся 3 байта первого окошка будут пустовать (padding bytes);uint8_t f3попадет в третье окошко;- Оставшиеся 3 байта 3-го окошка будут пустовать.
В сумме получаем 3 окошка по 4 байта.
Если в структуре есть поле типа другой структуры, окошко будет величиной не меньше, чем окошки этой вложенной структуры.
Alignment можно отключить, используя #pragma pack.
26. (продвинутый уровень): Размер структуры (4)
Заголовок раздела «26. (продвинутый уровень): Размер структуры (4)»#include <iostream>
struct A{};
int main(){ std::cout << sizeof(A) << std::endl;}Ответ:
Выведется 1.
Согласно стандарту C++, размер объекта не может быть меньше 1, чтобы возможно было различить 2 объекта этого типа между собой. Идея в том, что у 2 объектов не может быть тот же адрес памяти.
Про объекты есть в следующей лабе.
27. (продвинутый уровень): Отступ полей
Заголовок раздела «27. (продвинутый уровень): Отступ полей»#include <iostream>
struct A{ int a; int b;};
int main(){ std::cout << offsetof(A, a) << std::endl; std::cout << offsetof(A, b) << std::endl;}Ответ:
offsetof выполняется при компиляции и дает отступ в байтах заданного поля от начала струкуры.
Выведется 0 для a и 4 для b.
28. Инициализация поля массива
Заголовок раздела «28. Инициализация поля массива»#include <iostream>
struct A{ int arr[2];};
int main(){ A a { { 1, 2 } }; A b { { 3, 4 } }; b = a;
std::cout << b.arr[0] << std::endl; std::cout << b.arr[1] << std::endl;}Ответ:
Выведется 1, 2.
29. Копирование структуры с полем-массивом
Заголовок раздела «29. Копирование структуры с полем-массивом»#include <iostream>
struct A{ int arr[2];};
int main(){ A a { { 1, 2 } }; A b { a };
a.arr[0] = 3;
std::cout << b.arr[0] << std::endl; std::cout << b.arr[1] << std::endl; std::cout << a.arr[0] << std::endl; std::cout << a.arr[1] << std::endl;}Ответ:
A b{ a } копирует значения всех полей, включая массив целиком, поэлементно.
На момент копирования в a лежит arr[0] = 1, arr[1] = 2,
поэтому в b попадут те же значения: b.arr[0] = 1, b.arr[1] = 2.
Но это отдельная копия в отдельной памяти: сам массив arr
хранится внутри A по значению, а не по адресу.
Поэтому последующее изменение a.arr[0] = 3
меняет только a, а b остается нетронутым.
Выведется 1, 2, 3, 2.
30. Копирование структуры с полем-указателем
Заголовок раздела «30. Копирование структуры с полем-указателем»#include <iostream>
struct A{ int* pa; int a;};
int main(){ A s1{ nullptr, 1 }; s1.pa = &s1.a;
A s2{ s1 }; *s2.pa = 2;
std::cout << s1.a << std::endl; std::cout << s2.a << std::endl;}Ответ:
A s2{ s1 } копирует значения всех полей, но для указателя
копируется сам адрес, а не данные по этому адресу.
Это называется поверхностным копированием (shallow copy).
На момент копирования в s1 лежит a = 1, pa = &s1.a,
поэтому в s2 попадут те же значения: s2.a = 1, s2.pa = &s1.a.
Обратите внимание: s2.pa указывает на s1.a, а не на s2.a.
Поэтому *s2.pa = 2 идет по адресу &s1.a и перезаписывает s1.a,
а s2.a остается нетронутым.
Выведется 2, 1.
31. Массив структур
Заголовок раздела «31. Массив структур»#include <iostream>
struct A{ int f1; int f2;};
int main(){ A arr[3]{};
arr[0].f2 = 1;
arr[1] = A{ 2, 3 };
A copy { arr[2] }; copy.f1 = 4; copy.f2 = 5;
std::cout << arr[0].f1 << std::endl; std::cout << arr[0].f2 << std::endl; std::cout << arr[1].f1 << std::endl; std::cout << arr[1].f2 << std::endl; std::cout << arr[2].f1 << std::endl; std::cout << arr[2].f2 << std::endl;}Ответ:
Строчка A arr[3]{};:
- Определяет массив из трех переменных типа
A. В общей сложности выделется память под 6int-ов. - Фигурные скобки означают “инициализация нулями”.
Каждый элемент массива заполнится дефолтным
A, то естьA{}, что означает, что все 6int-ов станут нулями.
В arr[0].f2 = 1;, arr[0] получает доступ к памяти
первой переменной в массиве.
Эта переменная типа A (не int! очень важно понимать).
В ней внутри во второе поле (.f2) вписывается 1 (= 1).
arr[1] = A{ 2, 3 }; перезаписывает весь второй элемент
результатом выражения A{ 2, 3 }.
Это перезапишет оба поля.
A copy { arr[2] }; считывает из третьего элемента массива,
копируя то, что есть там, во временную переменную copy.
copy хранит копию значения из arr[2] типа A (то есть, имеет копию всех полей).
Следовательно, последующие воздействия на copy не повлияют на arr[2].
012300Задание
Заголовок раздела «Задание»Объяните словами что происходит в примере memory_example_2.
Можете скопировать файл с кодом и написать комментариями прямо в коде, что происходит.
Используйте excel таблицу из примера, чтобы визуализировать планировку памяти.
Можете в целом комментировать не каждый шаг, а что выведеться на каждом этапе, и почему (на что указывает в момент времени тот или иной указатель, что на данный момент записано в памяти, т.п.). Можете также использовать дебаггер для лучшего понимания.